Tworzenie stron www
Marketing
Pozycjonowanie
PR
Inne
O nas
Sklep
Blog Kontakt

SQL

SQL to język zapytań wykorzystywany do zarządzania danymi w bazach danych. Dzięki niemu można skutecznie przechowywać, wyszukiwać i modyfikować dane w aplikacjach internetowych, zapewniając ich wydajność i bezpieczeństwo.
Bazy danych SQL – projekt, optymalizacja, bezpieczeństwo, migracje i analityka

Baza danych, która nie spowalnia strony i nie gubi danych, gdy biznes rośnie

Pod niemal każdą dynamiczną stroną internetową działa relacyjna baza danych obsługiwana językiem SQL. Dopóki wszystko działa, nikt o niej nie myśli. Gdy panel administracyjny zaczyna się przycinać, filtry w sklepie odpowiadają po kilku sekundach albo import produktów kończy się błędem, przyczyną bardzo często okazuje się właśnie baza. Poniżej znajdziesz kompendium o historii i składni SQL, a w sekcjach obok praktykę: jak rozpoznać problemy, jak projektujemy i optymalizujemy bazy, jak je zabezpieczamy i przenosimy oraz jak SQL pomaga w analizie danych marketingowych.

Pracujemy z bazami MySQL, MariaDB i PostgreSQL w projektach na WordPressie, WooCommerce i PrestaShop, a także w aplikacjach pisanych w PHP i Pythonie. Projektujemy struktury danych, szukamy wolnych zapytań, przygotowujemy migracje i raporty. Szybsza baza to szybsza strona, a to przekłada się na wygodę użytkowników i ma znaczenie także dla pozycjonowania.

0rok publikacji artykułu Edgara F. Codda o modelu relacyjnym, od którego zaczęła się historia SQL
0rok przyjęcia SQL jako standardu ANSI; wkrótce potem standard przyjęła także organizacja ISO
0typowych objawów problemów z bazą danych, które opisujemy poniżej, zanim przejdziemy do rozwiązań
0etapów bezpiecznej migracji bazy, z próbnym przeniesieniem i planem wycofania zmian

SQL

SQL (Structured Query Language) to jeden z najważniejszych języków w świecie technologii, służący do zarządzania danymi w relacyjnych bazach danych. Historia powstania SQL sięga lat 70. XX wieku i jest ściśle związana z rozwojem koncepcji relacyjnych baz danych, która zrewolucjonizowała sposób przechowywania i przetwarzania informacji.

Początki – koncepcja relacyjnych baz danych

Podstawy teoretyczne SQL zostały opracowane przez Edgara F. Codda, brytyjskiego informatyka pracującego dla IBM. W 1970 roku Codd opublikował przełomowy artykuł zatytułowany „A Relational Model of Data for Large Shared Data Banks”. Przedstawił w nim model relacyjny, w którym dane są organizowane w formie tabel (relacji), umożliwiających efektywne przechowywanie i wyszukiwanie informacji.

Codd postulował, że dane w bazach powinny być dostępne w sposób deklaratywny, co oznacza, że użytkownik powinien określać co chce uzyskać, a nie jak to zrobić. Ta idea stała się podstawą SQL.

Rozwój SQL w IBM

IBM podjął się realizacji koncepcji Codda i w latach 70. rozpoczął projekt System R, który miał za zadanie stworzenie prototypu relacyjnej bazy danych. W ramach tego projektu, Donald Chamberlin i Raymond Boyce opracowali pierwszy język zapytań oparty na modelu relacyjnym, nazwany SEQUEL (Structured English Query Language). Nazwa została później skrócona do SQL z powodu problemów z prawami autorskimi.

System R z powodzeniem udowodnił praktyczność modelu relacyjnego, a SQL szybko zdobył uznanie jako standardowy język zapytań do baz danych.

Normalizacja SQL

W latach 80. SQL stał się podstawą dla pierwszych komercyjnych systemów relacyjnych baz danych, takich jak Oracle, DB2 (IBM) i Ingres. W 1986 roku organizacja ANSI (American National Standards Institute) zatwierdziła SQL jako standard, co zostało wkrótce zaadaptowane przez ISO (International Organization for Standardization).

Od tego czasu SQL jest regularnie rozwijany, a kolejne wersje standardu (SQL-89, SQL-92, SQL:1999, SQL:2003, SQL:2011 i SQL:2016) wprowadzają nowe funkcje i usprawnienia, takie jak obsługa XML, JSON czy analityczne funkcje okna.
SQL

Czym jest SQL

SQL to deklaratywny język programowania, zaprojektowany do pracy z danymi w relacyjnych bazach danych. W odróżnieniu od języków imperatywnych, takich jak C++ czy Python, SQL pozwala użytkownikowi skupić się na opisie pożądanego wyniku, pozostawiając szczegóły implementacji systemowi zarządzania bazą danych (DBMS).

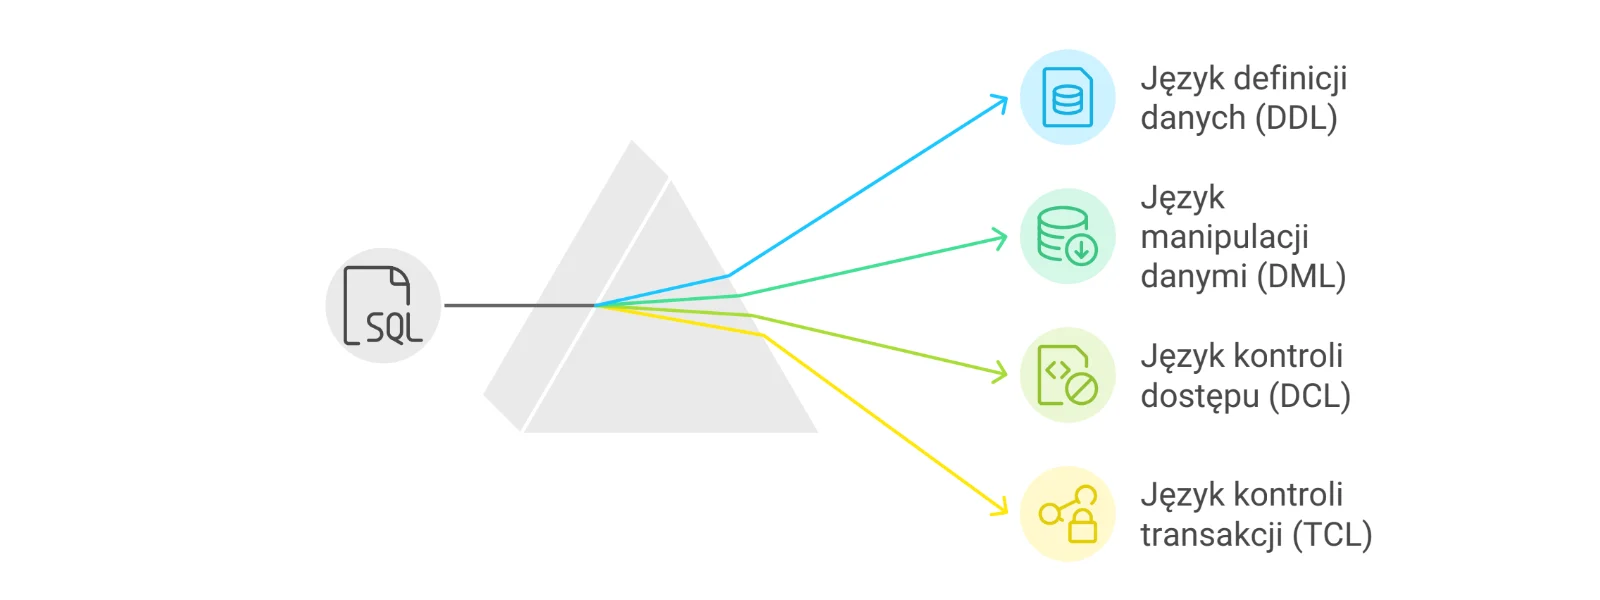
Podstawowe zastosowania SQL

  1. Definiowanie struktur danych (DDL)
    SQL umożliwia tworzenie, modyfikowanie i usuwanie tabel oraz innych obiektów w bazie danych. Są to operacje definiowania danych (ang. Data Definition Language, DDL).
  2. Manipulacja danymi (DML)
    SQL pozwala na dodawanie, modyfikowanie, usuwanie i wyszukiwanie danych w tabelach. Funkcje te należą do kategorii operacji manipulacji danymi (ang. Data Manipulation Language, DML).
  3. Kontrola dostępu (DCL)
    Za pomocą SQL można zarządzać uprawnieniami użytkowników do bazy danych, definiować role i zabezpieczenia.
  4. Obsługa transakcji (TCL)
    SQL obsługuje transakcje, co pozwala na grupowanie operacji w logiczne jednostki, zapewniając ich integralność i spójność.

Popularne systemy DBMS wykorzystujące SQL

SQL jest używany w wielu systemach zarządzania relacyjnymi bazami danych, takich jak:

  • Oracle Database – zaawansowany system o dużej funkcjonalności, popularny w przedsiębiorstwach.
  • MySQL – otwartoźródłowy system, szeroko stosowany w aplikacjach webowych.
  • PostgreSQL – system o rozbudowanych możliwościach, znany z elastyczności i wydajności.
  • Microsoft SQL Server – rozwiązanie firmy Microsoft, używane głównie w środowiskach Windows.
  • SQLite – lekki system bazodanowy, idealny do aplikacji mobilnych i wbudowanych.

Składnia SQL

Składnia SQL jest zwięzła i deklaratywna, co czyni ją stosunkowo łatwą do nauki, nawet dla początkujących użytkowników. Język ten składa się z zestawu komend, które można podzielić na kilka kategorii w zależności od ich zastosowania.

1. Data Definition Language (DDL)

DDL obejmuje polecenia do definiowania struktury bazy danych, takie jak:

  • Tworzenie nowych tabel, widoków i indeksów.
  • Modyfikowanie istniejących struktur.
  • Usuwanie obiektów z bazy danych.

Przykład zastosowania DDL obejmuje tworzenie tabel z określonymi typami danych i kluczami.

2. Data Manipulation Language (DML)

DML służy do pracy z danymi i obejmuje polecenia:

  • INSERT – dodawanie nowych rekordów do tabel.
  • UPDATE – modyfikowanie istniejących danych.
  • DELETE – usuwanie rekordów z tabel.
  • SELECT – wyszukiwanie i pobieranie danych.

Komenda SELECT jest najbardziej rozpoznawalnym elementem SQL i pozwala na wyszukiwanie danych przy użyciu różnych warunków, sortowania i grupowania.

3. Data Control Language (DCL)

DCL obejmuje zarządzanie dostępem użytkowników do bazy danych. Najważniejsze polecenia to:

  • GRANT – przyznawanie uprawnień do bazy danych lub jej elementów.
  • REVOKE – cofanie wcześniej przyznanych uprawnień.

4. Transaction Control Language (TCL)

TCL jest odpowiedzialny za zarządzanie transakcjami w bazie danych. Polecenia te obejmują:

  • COMMIT – zatwierdzenie zmian w bazie danych.
  • ROLLBACK – cofnięcie transakcji w razie wystąpienia błędu.
  • SAVEPOINT – ustawienie punktu kontrolnego w ramach transakcji.

5. Funkcje i operacje

SQL oferuje szeroką gamę funkcji wbudowanych, które pozwalają na operacje matematyczne, manipulację tekstem, datami czy funkcje agregujące, takie jak sumowanie, średnie czy zliczanie.
SQL a strony internetowe

Zastosowanie SQL w tworzeniu stron internetowych

SQL (Structured Query Language) odgrywa kluczową rolę w tworzeniu stron internetowych, szczególnie w aplikacjach dynamicznych, które wymagają przechowywania, przetwarzania i zarządzania danymi. Dzięki SQL możliwe jest zintegrowanie bazy danych z aplikacją internetową, co pozwala na tworzenie zaawansowanych funkcjonalności, takich jak systemy zarządzania treścią (CMS), sklepy internetowe czy portale społecznościowe.

Zarządzanie treścią na stronie internetowej

SQL jest fundamentem systemów zarządzania treścią (CMS), takich jak WordPress, Joomla czy Drupal. W tych systemach baza danych przechowuje:

  • Treści artykułów i postów: Wszystkie teksty publikowane na stronie, w tym blogi, artykuły i aktualności, są zapisane w bazie danych.
  • Dane multimedialne: Informacje o plikach, takich jak obrazy czy wideo, są przechowywane w bazach danych, umożliwiając ich łatwe zarządzanie i organizację.
  • Struktura strony: Nawigacja, kategorie i układ treści są definiowane i zarządzane przy użyciu zapytań SQL.

Dzięki SQL możliwe jest dynamiczne wyświetlanie treści, co pozwala użytkownikom na łatwą aktualizację witryny bez potrzeby edycji kodu.

Obsługa użytkowników i ich danych

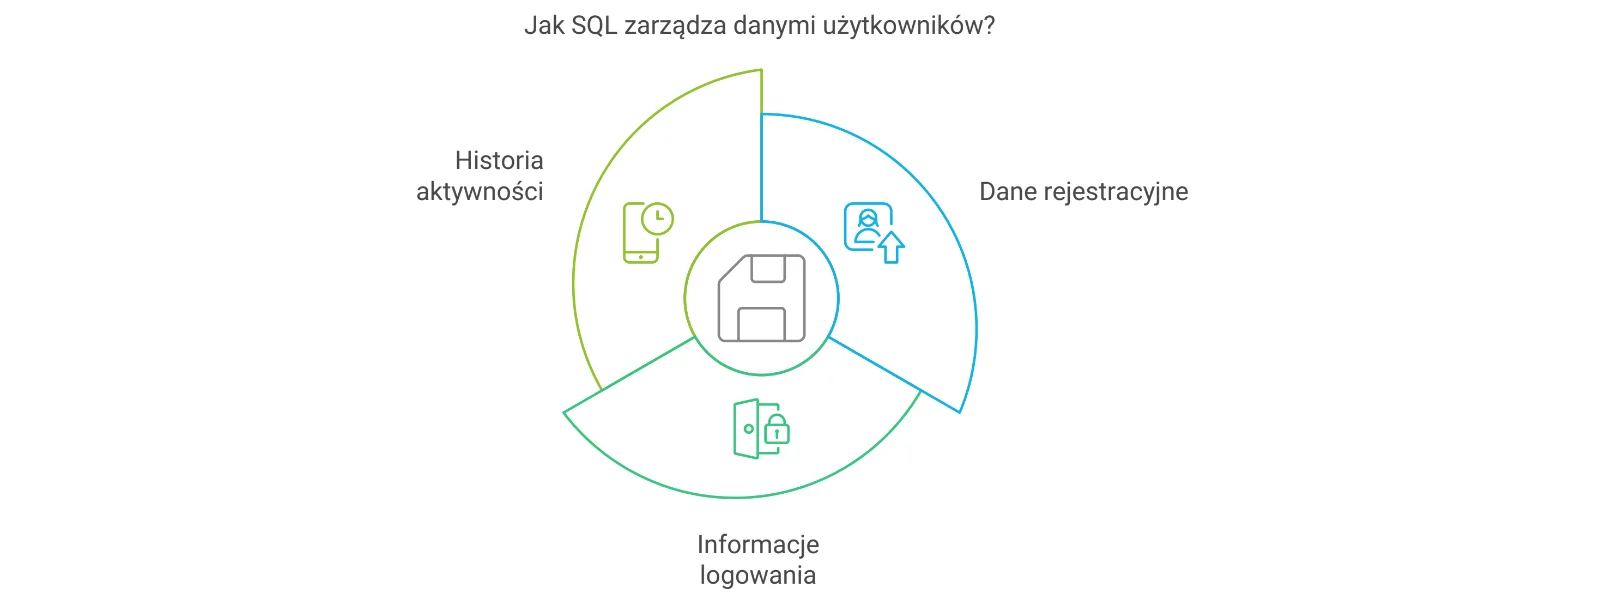
SQL jest powszechnie wykorzystywany do zarządzania danymi użytkowników. W aplikacjach internetowych, takich jak sklepy online, serwisy społecznościowe czy platformy edukacyjne, bazy danych obsługiwane przez SQL przechowują:

  • Dane rejestracyjne i logowania: Informacje o użytkownikach, takie jak nazwy użytkowników, hasła (zaszyfrowane), adresy e-mail i dane kontaktowe, są zapisane w tabelach.
  • Historie aktywności: SQL umożliwia zapisywanie informacji o działaniach użytkownika, takich jak przeglądane strony, zapisane zakładki czy historia zakupów.
  • Ustawienia konta: Dane konfiguracyjne, np. preferencje językowe czy powiadomienia, są przechowywane w bazie i dostosowywane dla każdego użytkownika.

Obsługa sklepów internetowych

SQL znajduje szerokie zastosowanie w platformach e-commerce, takich jak Magento, WooCommerce czy Shopify. W tych aplikacjach baza danych przechowuje i zarządza:

  • Informacjami o produktach: Dane o nazwach produktów, cenach, opisach, dostępności i kategoriach są zapisane w bazie i aktualizowane w czasie rzeczywistym.
  • Danymi zamówień: SQL umożliwia zapisywanie szczegółów dotyczących zamówień klientów, takich jak numery zamówień, produkty, statusy płatności i dostawy.
  • Danymi klientów: Informacje o klientach, w tym adresy wysyłkowe i preferencje zakupowe, są przechowywane i analizowane przy użyciu SQL.

Wyszukiwanie i filtrowanie treści

Jedną z kluczowych funkcji SQL w aplikacjach internetowych jest wyszukiwanie i filtrowanie treści. Dzięki zapytaniom SQL użytkownicy mogą szybko znajdować interesujące ich informacje. Przykłady zastosowań obejmują:

  • Wyszukiwanie produktów: W sklepach internetowych SQL umożliwia filtrowanie produktów według ceny, kategorii czy dostępności.
  • Wyszukiwanie użytkowników: W portalach społecznościowych SQL pozwala na odnajdywanie osób według kryteriów takich jak wiek, lokalizacja czy zainteresowania.
  • Filtrowanie treści: W aplikacjach z dużą ilością danych SQL umożliwia dynamiczne sortowanie i grupowanie informacji.

Analiza danych i personalizacja

SQL jest również kluczowym narzędziem do analizy danych gromadzonych przez strony internetowe. Wyniki analizy są wykorzystywane do personalizacji doświadczeń użytkowników oraz optymalizacji działania aplikacji. SQL umożliwia:

  • Generowanie raportów: Na podstawie zapytań SQL można analizować liczbę odwiedzin, sprzedaż, zachowania użytkowników i inne metryki.
  • Personalizację treści: Dzięki analizie danych przechowywanych w bazie, aplikacje mogą dynamicznie dostosowywać treści do indywidualnych preferencji użytkownika.
  • Rekomendacje: SQL umożliwia budowę systemów rekomendacji, które sugerują produkty, treści czy usługi na podstawie historii użytkownika.

Integracja z technologiami backendowymi

SQL współpracuje z różnymi językami programowania, takimi jak PHP, Python, Ruby czy JavaScript, które są używane w backendzie aplikacji internetowych. Dzięki temu możliwa jest:

  • Dynamiczna aktualizacja treści: Backend wykorzystuje zapytania SQL do pobierania i modyfikowania danych w bazie w odpowiedzi na interakcje użytkowników.
  • Obsługa API: SQL jest używany do zasilania interfejsów API, które łączą się z aplikacjami mobilnymi lub zewnętrznymi serwisami.

SQL jest niezastąpionym narzędziem w procesie tworzenia stron internetowych. Umożliwia zarządzanie treścią, obsługę użytkowników, analizę danych i personalizację, co czyni go podstawą nowoczesnych aplikacji dynamicznych. Jego uniwersalność, łatwość integracji z innymi technologiami i skalowalność sprawiają, że pozostaje jednym z najważniejszych języków w świecie web developmentu.

Jeśli planujesz stworzenie strony internetowej, która wykorzystuje potencjał baz danych, zespół SEOSEM24 pomoże Ci wdrożyć rozwiązania oparte na SQL i zoptymalizować Twoją aplikację pod kątem wydajności i bezpieczeństwa. Skontaktuj się z nami już dziś, aby dowiedzieć się więcej!

Diagnoza

Osiem objawów, że problem leży w bazie danych, a nie w szablonie czy hostingu

Klienci rzadko zgłaszają się z hasłem „mamy problem z bazą”. Mówią raczej, że strona jest wolna albo że coś przestało działać. Te sygnały najczęściej prowadzą nas do analizy zapytań i struktury danych.

01

Wolny panel administracyjny

Strona dla odwiedzających działa sprawnie dzięki pamięci podręcznej, ale lista zamówień czy produktów w panelu ładuje się bardzo długo. Panel zwykle omija cache, więc odsłania prawdziwą szybkość zapytań.

02

Filtry i wyszukiwarka odpowiadają z opóźnieniem

Każde zaznaczenie filtra w sklepie to nowe zapytanie, często łączące wiele tabel. Bez odpowiednich indeksów czas odpowiedzi rośnie wraz z liczbą produktów i atrybutów.

03

Importy kończą się błędem

Aktualizacja stanów magazynowych lub cen z pliku przerywa się po przekroczeniu limitu czasu. Przyczyną bywa zapisywanie rekordów pojedynczo zamiast partiami albo blokady tabel w trakcie operacji.

04

Błędy połączenia przy większym ruchu

Komunikaty o zbyt wielu połączeniach z bazą pojawiają się w czasie kampanii lub wyprzedaży. Zwykle oznaczają, że pojedyncze zapytania trwają za długo i blokują kolejne żądania.

05

Baza rośnie bez wyraźnego powodu

Rozmiar bazy zwiększa się szybciej niż liczba treści i zamówień. Winne bywają logi wtyczek, nieusuwane sesje, wygasłe dane tymczasowe i kolejne wersje wpisów zapisywane bez limitu.

06

Sporadyczne błędy przy zamówieniach

Pojedyncze zamówienia nie zapisują się poprawnie albo stany magazynowe nie zgadzają się z rzeczywistością. Może to wskazywać na zakleszczenia, brak transakcji lub równoczesne aktualizacje tych samych rekordów.

07

Znaki zapytania zamiast polskich liter

Po przeniesieniu strony lub imporcie danych w miejscu polskich znaków albo emoji pojawiają się krzaki. To objaw niespójnego kodowania znaków między bazą, tabelami i połączeniem aplikacji.

08

Problemy po aktualizacji serwera

Po zmianie wersji MySQL, MariaDB lub PHP część funkcji przestaje działać. Starsze zapytania mogą korzystać ze składni lub trybów, które w nowszej wersji działają inaczej albo zostały wycofane.

W skrócie

Dobrze zaprojektowana baza

  • Model danych uzgodniony przed kodem
  • Klucze główne i obce pilnujące spójności
  • Typy danych dobrane do zawartości
  • Ograniczenia zamiast walidacji tylko w aplikacji
  • Kodowanie utf8mb4 lub UTF-8 w całej bazie
  • Zmiany struktury przez migracje
Omów swój projekt
Projekt bazy danych

Struktura danych, która wytrzyma kolejne lata rozwoju aplikacji

Błędy w projekcie bazy są jednymi z najdroższych do naprawienia, bo ujawniają się dopiero wtedy, gdy w tabelach są już setki tysięcy rekordów, a na ich strukturze opiera się kod całej aplikacji. Dlatego przy projektach budowanych od podstaw zaczynamy od modelu danych: jakie obiekty występują w biznesie klienta, jakie mają cechy, jak są ze sobą powiązane i które z tych powiązań mogą się zmieniać w czasie. Taki model omawiamy z klientem na diagramie, zanim powstanie pierwsza tabela.

Normalizacja z głową

Zasady normalizacji mówią, by każda informacja była zapisana w jednym miejscu. Adres klienta nie powinien być kopiowany do każdego zamówienia, jeśli ma się zmieniać razem z danymi klienta. Z drugiej strony zamówienie musi zapamiętać adres i cenę z chwili zakupu, nawet jeśli klient później się przeprowadzi, a cena produktu wzrośnie. Dobry projekt odróżnia dane bieżące od historycznych i świadomie decyduje, gdzie dopuszcza powtórzenia, na przykład w tabelach raportowych przygotowanych do szybkiego odczytu.

Decyzje, które podejmujemy na początku

  • Klucze i relacje. Każda tabela ma klucz główny, a powiązania między tabelami są zabezpieczone kluczami obcymi. Baza sama nie pozwoli wtedy zapisać zamówienia dla nieistniejącego klienta ani usunąć produktu, do którego odwołują się zamówienia.
  • Typy danych. Kwoty zapisujemy w typach dziesiętnych o stałej precyzji, a nie zmiennoprzecinkowych, które mogą powodować błędy zaokrągleń. Daty przechowujemy w typach dat, a nie w tekście, ze świadomym podejściem do stref czasowych.
  • Ograniczenia w bazie. Warunki takie jak wymagane pole, unikalny adres e-mail czy dodatnia ilość produktu definiujemy także w bazie, nie tylko w kodzie. Jeśli kiedyś dane trafią do bazy inną drogą, na przykład przez import, ograniczenia nadal zadziałają.
  • Kodowanie znaków. W MySQL i MariaDB stosujemy zestaw znaków utf8mb4, bo starszy zestaw utf8 nie obsługuje wszystkich znaków Unicode, na przykład emoji. Spójne kodowanie bazy, tabel i połączenia eliminuje problem krzaków przy przenosinach.

Usuwanie, historia i wielojęzyczność

Już na etapie projektu decydujemy, co oznacza usunięcie rekordu. Czasem dane naprawdę powinny zniknąć, na przykład na żądanie klienta korzystającego z prawa do usunięcia danych. Czasem lepiej je tylko oznaczyć jako nieaktywne, żeby nie stracić historii zamówień i raportów. Podobnie z historią zmian: jeśli firma musi wiedzieć, kto i kiedy zmienił cenę albo status zamówienia, potrzebna jest osobna tabela zdarzeń. Przy serwisach wielojęzycznych ustalamy, które pola są tłumaczone, a które wspólne dla wszystkich wersji, i projektujemy pod to tabele.

Zmiany struktury pod kontrolą

Struktura bazy zmienia się razem z aplikacją. Każdą zmianę, czyli nowe pole, indeks czy tabelę, zapisujemy jako migrację w repozytorium kodu. Dzięki temu środowisko deweloperskie, testowe i produkcyjne mają identyczny schemat, a historia zmian jest udokumentowana. Przy dużych tabelach planujemy migracje tak, by nie blokowały bazy na długo, na przykład dodając kolumnę i wypełniając ją danymi w osobnych krokach.

W gotowych systemach, takich jak WordPress czy PrestaShop, struktury głównych tabel nie zmieniamy, bo utrudniłoby to aktualizacje. Własne dane przechowujemy w osobnych tabelach z prefiksem projektu albo w mechanizmach przewidzianych przez system.
Wybór systemu bazy danych

MySQL i MariaDB czy PostgreSQL? Porównanie dla projektów webowych

W projektach stron i sklepów internetowych najczęściej wybiera się między tymi dwiema rodzinami systemów. Obie są otwarte, dojrzałe i wydajne. Decyzję często przesądza nie sama baza, lecz system lub framework, który ma na niej działać.

MySQL i MariaDB

Najpopularniejsze bazy w świecie hostingu stron. MariaDB powstała jako odgałęzienie MySQL, rozwijane przez jego twórców.

  • Wymagane przez WordPressa, WooCommerce, PrestaShop i Magento
  • Dostępne praktycznie na każdym hostingu, także współdzielonym
  • Ogromna liczba administratorów i programistów znających te systemy
  • Silnik InnoDB z transakcjami, kluczami obcymi i blokadami na poziomie wierszy
  • Między MySQL a MariaDB narastają różnice, więc przenosiny nie zawsze są bezproblemowe
  • Starsze konfiguracje bywają pobłażliwe wobec błędnych danych, jeśli nie włączono trybu ścisłego
Naturalny wybór dla stron i sklepów na popularnych systemach CMS oraz aplikacji w PHP.

PostgreSQL

Rozbudowany system obiektowo-relacyjny, ceniony za zgodność ze standardem i bogactwo funkcji.

  • Zaawansowane typy danych, w tym JSONB, tablice i zakresy
  • Rozszerzenia, na przykład PostGIS do danych geograficznych
  • Wbudowane wyszukiwanie pełnotekstowe i indeksy częściowe
  • Częsty wybór w aplikacjach na Django i w analityce
  • Rzadziej dostępny na tanim hostingu współdzielonym
  • Większość popularnych systemów CMS w PHP go nie obsługuje
Dobry wybór dla aplikacji budowanych od podstaw, złożonych modeli danych, danych przestrzennych i raportowania.

Inne bazy w projektach webowych

SQLite to baza zapisywana w jednym pliku, bez osobnego serwera. Świetnie sprawdza się w aplikacjach mobilnych, narzędziach lokalnych, testach automatycznych i mniejszych projektach, ale przy wielu jednoczesnych zapisach ustępuje bazom serwerowym. Microsoft SQL Server i Oracle Database spotykamy głównie przy integracjach z systemami firmowymi, na przykład przy synchronizacji sklepu z systemem ERP, który działa na jednej z tych baz.

Bazy nierelacyjne, takie jak bazy dokumentowe czy magazyny klucz–wartość, mają swoje zastosowania: pamięć podręczną, kolejki, wyszukiwarki pełnotekstowe, logi. W większości projektów stron i sklepów nie zastępują jednak bazy relacyjnej, lecz ją uzupełniają. Dane, które muszą być spójne, takie jak zamówienia, płatności czy stany magazynowe, nadal najlepiej przechowywać w bazie z transakcjami i relacjami.

Przy wyborze bierzemy pod uwagę także kwestie praktyczne: jakie bazy oferuje dostawca hostingu lub chmury, czy jest dostępna usługa zarządzanej bazy z automatycznymi kopiami i aktualizacjami, kto w firmie będzie administrował serwerem i jakie systemy będą się z bazą łączyć. Zarządzana baza w chmurze jest zwykle droższa od samodzielnej instalacji na serwerze, ale zdejmuje z zespołu znaczną część obowiązków administracyjnych.

Optymalizacja

Sześć obszarów, w których szukamy przyspieszenia bazy danych

Optymalizacja bazy nie polega na zgadywaniu. Zaczynamy od pomiaru, znajdujemy zapytania, które zajmują najwięcej czasu, i dopiero wtedy wprowadzamy zmiany, sprawdzając ich efekt.

Najpierw pomiar, potem zmiany

W MySQL i MariaDB włączamy dziennik wolnych zapytań, który zapisuje zapytania przekraczające ustalony czas. W PostgreSQL korzystamy z rozszerzenia pg_stat_statements, zbierającego statystyki wszystkich wykonywanych zapytań. W WordPressie pomocna jest wtyczka Query Monitor, która pokazuje, jakie zapytania generuje konkretna podstrona i która wtyczka za nie odpowiada.

Patrzymy nie tylko na najwolniejsze zapytania, ale też na te, które wykonują się bardzo często. Zapytanie trwające ułamek sekundy, ale uruchamiane tysiące razy na minutę, może obciążać bazę bardziej niż jeden raport wykonywany raz dziennie.

  • Dziennik wolnych zapytań
  • Statystyki zapytań w PostgreSQL
  • Analiza zapytań per podstrona
  • Pomiar przed i po zmianie
Bezpieczeństwo danych

Sześć zasad ochrony bazy, które stosujemy w każdym projekcie

W bazie danych strony lub sklepu są dane klientów, zamówienia, konta użytkowników i cała treść serwisu. Jej wyciek albo utrata to dla firmy jeden z najpoważniejszych incydentów, także w świetle przepisów o ochronie danych osobowych.

Zapytania parametryzowane

Dane od użytkownika nigdy nie są doklejane do treści zapytania. Korzystamy z zapytań przygotowanych z parametrami albo z warstwy ORM, która robi to automatycznie. To podstawowa ochrona przed atakami typu SQL injection, wciąż jednymi z najgroźniejszych dla aplikacji webowych.

Minimalne uprawnienia

Aplikacja łączy się z bazą kontem, które ma dostęp tylko do własnej bazy i tylko do potrzebnych operacji. Osobne konta służą do migracji, raportów i kopii zapasowych. Włamanie do jednej części systemu nie daje wtedy władzy nad całym serwerem.

Baza niewidoczna z internetu

Serwer bazy przyjmuje połączenia tylko z serwera aplikacji lub z sieci wewnętrznej. Zdalny dostęp dla administratorów odbywa się przez szyfrowany tunel, a nie przez otwarty port. Narzędzia do zarządzania bazą przez przeglądarkę zabezpieczamy dodatkowo albo wyłączamy.

Kopie, które da się odtworzyć

Kopie zapasowe wykonujemy automatycznie, przechowujemy poza serwerem produkcyjnym i okresowo sprawdzamy, odtwarzając je na osobnym środowisku. Przy bazach, w których utrata nawet kilku godzin danych byłaby dotkliwa, stosujemy także archiwizację dzienników transakcji.

Szyfrowanie i skróty haseł

Hasła użytkowników zapisujemy wyłącznie jako skróty utworzone algorytmami przeznaczonymi do tego celu, nigdy w postaci jawnej. Połączenia z bazą działającą na innym serwerze szyfrujemy, a szczególnie wrażliwe pola można dodatkowo szyfrować na poziomie aplikacji.

Minimalizacja danych osobowych

Przechowujemy tylko dane potrzebne do realizacji celu i usuwamy je po określonym czasie. Kopie bazy używane na środowiskach testowych anonimizujemy, żeby prawdziwe dane klientów nie trafiały na komputery programistów ani do narzędzi zewnętrznych.

Dostęp dla zewnętrznych wykonawców

Przy współpracy z kilkoma firmami, na przykład agencją, dostawcą integracji i księgowością, każda strona powinna mieć własne konto z uprawnieniami ograniczonymi do swojego zakresu. Wspólne hasło do bazy przekazywane mailem to proszenie się o kłopoty: po zakończeniu współpracy nie wiadomo, kto je jeszcze zna. Indywidualne konta można w każdej chwili wyłączyć, a działania na nich przypisać konkretnej osobie. Zasady dostępu warto opisać także w umowach powierzenia przetwarzania danych.

Migracja bazy danych

Przeniesienie bazy na nowy serwer lub system w sześciu etapach

Migracja bywa konieczna przy zmianie hostingu, aktualizacji wersji serwera bazy, przejściu z MySQL na MariaDB albo przebudowie aplikacji. Najważniejszą zasadą jest próbne przeniesienie przed właściwym i gotowy plan powrotu.

1

Inwentaryzacja

Sprawdzamy rozmiar bazy, wersję serwera, kodowanie znaków, silniki tabel, procedury składowane, wyzwalacze i zadania cykliczne. Ustalamy też, jakie aplikacje i integracje korzystają z bazy, bo często jest ich więcej, niż wynika z dokumentacji.

przegląd struktury i zależnościlista systemów korzystających z bazy
2

Próbne przeniesienie

Przygotowujemy środowisko docelowe i przenosimy na nie kopię bazy. Już ten krok pokazuje, ile czasu zajmie właściwa migracja i jakie błędy wystąpią przy imporcie, na przykład związane z kodowaniem czy trybem ścisłym nowszej wersji serwera.

kopia na środowisku testowympomiar czasu operacji
3

Dostosowanie struktur i zapytań

Poprawiamy elementy, które w nowym środowisku działają inaczej: typy danych, kodowanie, składnię zapytań i ustawienia serwera. Przy zmianie systemu bazy, na przykład z MySQL na PostgreSQL, ten etap obejmuje też konwersję schematu i przegląd zapytań w kodzie aplikacji.

konwersja schematupoprawki w zapytaniach
4

Testy aplikacji na nowej bazie

Uruchamiamy stronę lub aplikację na przeniesionej bazie i sprawdzamy kluczowe funkcje: logowanie, zamówienia, wyszukiwanie, importy, raporty. Porównujemy czasy odpowiedzi z dotychczasowym środowiskiem, by upewnić się, że migracja nie pogorszy wydajności.

testy funkcjonalneporównanie wydajności
5

Okno migracji i przełączenie

W ustalonym terminie, zwykle w okresie najmniejszego ruchu, wstrzymujemy zapisy, wykonujemy końcową kopię i przenosimy dane. Przy dużych bazach, które nie mogą być niedostępne długo, stosujemy replikację i przełączamy aplikację na nową bazę po zsynchronizowaniu danych.

termin uzgodniony z klientemreplikacja przy dużych bazach
6

Weryfikacja i plan powrotu

Porównujemy liczby rekordów i sumy kontrolne kluczowych tabel, monitorujemy błędy i wydajność. Stara baza pozostaje nietknięta do czasu potwierdzenia, że wszystko działa, więc w razie problemu można szybko wrócić do poprzedniego stanu.

sumy kontrolne i monitoringgotowy plan wycofania
W skrócie

Zdrowa synchronizacja danych

  • Jedno źródło prawdy dla każdego pola
  • Stałe identyfikatory zamiast nazw
  • Import do tabeli pośredniej i walidacja
  • Zapis partiami, w transakcjach
  • Raport błędów i alerty
  • Przemyślane wycofywanie produktów
Zapytaj o integrację
Integracje

Importy, eksporty i synchronizacja: jak nie zgubić danych po drodze

Baza sklepu czy portalu rzadko żyje w izolacji. Ceny i stany magazynowe przychodzą z systemu ERP, oferta dostawców z plików udostępnianych przez hurtownie, zamówienia trafiają do księgowości i firm kurierskich, a dane produktów do porównywarek i marketplaceów. Każda taka wymiana to miejsce, w którym dane mogą się rozjechać, zdublować albo zniknąć. Większość problemów, które rozwiązujemy przy integracjach, nie wynika z błędów w kodzie, lecz z braku jasnych zasad, który system za co odpowiada.

Zasady, od których zaczynamy

  • Jedno źródło prawdy. Dla każdego rodzaju danych ustalamy, który system jest nadrzędny. Jeśli ceny pochodzą z ERP, to zmiana ceny w panelu sklepu zostanie nadpisana przy najbliższej synchronizacji, a zespół musi o tym wiedzieć.
  • Stałe identyfikatory. Rekordy dopasowujemy po kodach, takich jak indeks magazynowy czy kod EAN, a nie po nazwach, które zmieniają się przy każdej korekcie opisu. Gdy systemy używają różnych kodów, tworzymy tabelę mapowania.
  • Tabela pośrednia. Dane z pliku lub API najpierw trafiają do tabeli tymczasowej. Tam sprawdzamy ich kompletność i poprawność, a dopiero potem scalamy je z danymi produkcyjnymi jedną operacją wstawienia lub aktualizacji. Uszkodzony plik od dostawcy nie wyzeruje wtedy stanów całego sklepu.
  • Partie i transakcje. Duże importy dzielimy na partie zapisywane w transakcjach. Zamiast tysięcy pojedynczych zapytań baza wykonuje kilkadziesiąt większych, a przerwany import można bezpiecznie powtórzyć bez dublowania rekordów.

Co z produktami, które znikają z oferty

To pytanie łączy bazy danych z pozycjonowaniem. Jeśli import usuwa z bazy produkty, których nie ma już w pliku dostawcy, ich podstrony z dnia na dzień zwracają błąd, a zdobyte przez nie pozycje i linki przepadają. Dlatego produkty wycofane z oferty zwykle oznaczamy jako niedostępne zamiast je usuwać, a o dalszym losie ich adresów, czyli pozostawieniu strony, przekierowaniu do następcy lub kategorii, decydujemy według ustalonych reguł. Te reguły uzgadniamy z zespołem SEO, zanim integracja zostanie uruchomiona.

Monitoring wymiany danych

Każda synchronizacja zapisuje przebieg: ile rekordów przetworzono, ile dodano, zmieniono i odrzucono, z podaniem powodu. Jeśli import się nie wykona albo liczba zmian znacznie odbiega od typowej, odpowiedzialne osoby dostają powiadomienie. Lepiej dowiedzieć się o problemie z plikiem dostawcy z alertu o szóstej rano niż od klientów, którzy zamówili produkty niedostępne od tygodnia.

Przy większej skali wymianę danych między wieloma systemami lepiej oprzeć na osobnej usłudze integracyjnej, która zarządza kolejką zadań i ponawianiem, zamiast na zadaniach uruchamianych bezpośrednio w sklepie. Takie usługi budujemy często w Pythonie lub PHP.
W skrócie

SQL w marketingu i SEO

  • Surowe dane GA4 w BigQuery
  • Zbiorczy eksport danych z Search Console
  • Połączenie z danymi sprzedaży ze sklepu
  • Raporty w Looker Studio
  • Zapytania ograniczone do potrzebnych dat i kolumn
Analityka biznesowa
SQL w analityce

SQL to nie tylko bazy stron. To także język analizy danych marketingowych

Panele narzędzi analitycznych odpowiadają na typowe pytania, ale szybko natrafiają na ograniczenia: próbkowanie, agregację, brak możliwości połączenia z danymi z innych systemów. Gdy firma chce wiedzieć, z jakich kanałów przychodzą klienci, którzy kupują ponownie, albo które zapytania w wyszukiwarce prowadzą do najbardziej dochodowych zamówień, potrzebny jest dostęp do surowych danych i język, który pozwala je swobodnie łączyć. Tym językiem jest SQL.

Źródła danych, z którymi pracujemy

  • Google Analytics 4. Właściwość GA4 można połączyć z BigQuery i eksportować do niego surowe zdarzenia. Dane trafiają do tabel, na których można odtworzyć ścieżki użytkowników, zbudować własne modele atrybucji i analizy kohortowe niedostępne w standardowych raportach.
  • Google Search Console. Zbiorczy eksport danych do BigQuery udostępnia dane o zapytaniach i podstronach bez ograniczeń liczby wierszy, które obowiązują w interfejsie i przy zwykłym eksporcie. Przy dużych serwisach to podstawa rzetelnej analizy widoczności.
  • Baza sklepu i systemy firmowe. Zamówienia, zwroty, marże i dane klientów z bazy sklepu albo systemu ERP pozwalają ocenić kanały marketingowe przez pryzmat zysku, a nie tylko liczby transakcji.

Jak budujemy raporty

Zaczynamy od pytań biznesowych, a nie od tabel. Ustalamy z klientem, jakie decyzje mają wspierać raporty, i dopiero potem projektujemy zapytania. Dane przetwarzamy etapami: najpierw oczyszczamy je i ujednolicamy, potem tworzymy tabele pośrednie z gotowymi miarami, a na końcu podłączamy je do narzędzia wizualizacji, na przykład Looker Studio. Dzięki temu raport ładuje się szybko, a logika obliczeń jest zapisana w jednym miejscu i łatwo ją sprawdzić.

W BigQuery koszt zapytania zależy od ilości przetworzonych danych, dlatego piszemy zapytania, które odczytują tylko potrzebne kolumny i zakres dat, a tabele dzielimy na partycje według dnia. Raporty odświeżają się automatycznie według harmonogramu, więc nikt nie musi co tydzień ręcznie kopiować danych między arkuszami.

Ważna jest też spójność definicji. Jeśli dział sprzedaży liczy przychód brutto, a marketing netto bez kosztów dostawy, raporty będą się różnić, choć oba będą „poprawne”. Dlatego definicje miar, takich jak przychód, nowy klient czy zwrot, zapisujemy w jednym miejscu i opisujemy w dokumentacji raportu.

Przykładowe pytania, na które odpowiada SQL

  • Które grupy zapytań z wyszukiwarki prowadzą do zamówień o najwyższej marży?
  • Ilu klientów pozyskanych w danym miesiącu wraca po kolejne zakupy i po jakim czasie?
  • Które podstrony tracą widoczność i jak przekłada się to na sprzedaż w ich kategoriach?
  • Jak zmienia się średnia wartość zamówienia w zależności od źródła pierwszej wizyty?
Dane osobowe: do analiz marketingowych zwykle nie są potrzebne dane pozwalające zidentyfikować klienta. Pracujemy na identyfikatorach i danych zagregowanych, a zakres przetwarzania ustalamy z klientem jako administratorem danych.
Zakres usług

W czym pomagamy przy bazach danych stron, sklepów i aplikacji

Prace bazodanowe rzadko są osobnym projektem. Najczęściej towarzyszą budowie strony, rozwojowi sklepu, migracji albo pracom analitycznym. Poniżej zadania, z którymi klienci zwracają się do nas najczęściej.

01

Projekt bazy dla nowej aplikacji

Model danych, schemat tabel, klucze, indeksy i ograniczenia przygotowane razem z zespołem klienta, z dokumentacją i migracjami w repozytorium.

  • Diagram i opis modelu
  • Migracje od pierwszego dnia
02

Audyt i optymalizacja wydajności

Znalezienie zapytań spowalniających stronę, poprawa indeksów i konfiguracji serwera oraz pomiar efektu przed i po zmianach.

  • Analiza wolnych zapytań
  • Raport z priorytetami
03

Porządki w WordPressie i sklepie

Analiza tabel meta i opcji, usunięcie pozostałości po wtyczkach, ograniczenie wersji wpisów i danych tymczasowych, przygotowanie bazy WooCommerce na większą skalę.

  • Bezpieczne czyszczenie danych
  • Usunięcie przyczyn rozrostu
04

Migracje i aktualizacje

Przeniesienie bazy na nowy serwer, aktualizacja wersji MySQL, MariaDB lub PostgreSQL, zmiana systemu bazy przy przebudowie aplikacji, z próbnym przeniesieniem i planem powrotu.

  • Migracja testowa
  • Weryfikacja spójności danych
05

Integracje i wymiana danych

Synchronizacja sklepu z systemami ERP, hurtowniami i marketplace’ami, importy plików od dostawców i eksporty do porównywarek, z monitoringiem i raportami błędów.

  • Mapowanie identyfikatorów
  • Alerty o nieudanych importach
06

Raporty i hurtownie danych

Zapytania analityczne, eksport danych do BigQuery, łączenie danych sprzedaży z danymi z GA4 i Search Console oraz automatycznie odświeżane raporty dla marketingu i zarządu.

  • Raporty oparte na pytaniach biznesowych
  • Kontrola kosztów zapytań
FAQ

Najczęstsze pytania o bazy danych i SQL

Odpowiedzi na pytania, które zadają nam właściciele stron i sklepów, a także zespoły marketingu pracujące z danymi.

Czy optymalizacja bazy ma sens, jeśli strona korzysta już z pamięci podręcznej?
Tak. Pamięć podręczna stron działa głównie dla niezalogowanych odwiedzających i treści, które się nie zmieniają. Koszyk, zamówienie, konto klienta, wyszukiwarka, filtry i cały panel administracyjny korzystają z bazy przy każdym wywołaniu. W sklepie to właśnie te miejsca decydują o sprzedaży, a ich szybkość zależy od zapytań i struktury danych.
Jak często wykonywać kopie zapasowe bazy?
Tak często, by utrata danych od ostatniej kopii była do zaakceptowania. Dla strony firmowej aktualizowanej raz w tygodniu wystarczy kopia dzienna. Dla sklepu przyjmującego zamówienia przez całą dobę często potrzebne są kopie częstsze albo ciągła archiwizacja dzienników transakcji. Niezależnie od częstotliwości kopie powinny być przechowywane poza serwerem i regularnie testowane.
Dlaczego baza mojego WordPressa jest tak duża?
Najczęstsze przyczyny to nieograniczona liczba wersji wpisów, wygasłe dane tymczasowe, logi zapisywane przez wtyczki, sesje sklepu, statystyki odwiedzin trzymane w bazie i pozostałości po usuniętych wtyczkach. Zanim cokolwiek usuniemy, sprawdzamy, które tabele rosną i dlaczego, bo samo czyszczenie bez usunięcia przyczyny daje efekt tylko na kilka tygodni.
Czy mogę sam wyczyścić bazę wtyczką optymalizującą?
Można, ale zawsze po wykonaniu i sprawdzeniu kopii zapasowej. Automatyczne narzędzia nie wiedzą, które dane są dla Ciebie ważne, i mogą usunąć na przykład ustawienia wtyczki, którą planujesz ponownie włączyć. Bezpieczne są zwykle operacje na wygasłych danych tymczasowych i starszych wersjach wpisów. Ingerencję w tabele meta i opcje lepiej zostawić osobie, która rozumie ich zawartość.
MySQL czy MariaDB: czy dla WordPressa to ma znaczenie?
WordPress, WooCommerce i większość wtyczek działają poprawnie na obu systemach w wersjach wspieranych. Ważniejsze od wyboru marki są aktualna wersja, poprawna konfiguracja i zasoby serwera. Ostrożność jest potrzebna przy przenoszeniu bazy między tymi systemami, bo w nowszych wersjach różnią się one niektórymi domyślnymi ustawieniami i obsługą części funkcji.
Czy warto aktualizować wersję serwera bazy danych?
Tak, i to nie tylko ze względu na nowe funkcje. Starsze wersje po zakończeniu wsparcia nie otrzymują poprawek bezpieczeństwa. Aktualizację przeprowadzamy jak migrację: najpierw na kopii, z testami aplikacji, bo zmiany w domyślnych ustawieniach, trybach SQL czy sposobie uwierzytelniania potrafią zatrzymać działanie starszego kodu.
Czy SQL injection to wciąż realne zagrożenie?
Tak. Nowoczesne frameworki i systemy CMS chronią przed nim, jeśli korzysta się z ich mechanizmów, ale podatności regularnie pojawiają się we wtyczkach, modułach i własnym kodzie, w którym zapytania składa się z tekstu. Dlatego aktualizujemy rozszerzenia, przeglądamy własny kod pod tym kątem i ograniczamy uprawnienia konta, z którego aplikacja łączy się z bazą.
Czy baza danych wpływa na pozycjonowanie strony?
Pośrednio tak. Wolne zapytania wydłużają czas odpowiedzi serwera, co przekłada się na szybkość ładowania i doświadczenia użytkowników. Przeciążona baza może też powodować błędy serwera, które widzą zarówno klienci, jak i roboty wyszukiwarek. Przy dużych serwisach szybka odpowiedź serwera pomaga też robotom sprawniej odwiedzać kolejne podstrony.
Czy przygotujecie raporty z danych sklepu bez obciążania produkcji?
Tak. Ciężkie zapytania raportowe nie powinny działać na bazie obsługującej zamówienia w godzinach szczytu. Korzystamy z repliki tylko do odczytu, cyklicznego eksportu danych do hurtowni, na przykład BigQuery, albo z konta z ograniczonymi uprawnieniami i zapytań uruchamianych w nocy. Dobór metody zależy od wielkości bazy i tego, jak świeże dane są potrzebne.
Czym różni się kopia logiczna od fizycznej?
Kopia logiczna to zapis struktury i danych w postaci poleceń SQL lub plików eksportu. Jest przenośna między wersjami i serwerami, ale przy dużych bazach jej wykonanie i odtworzenie trwa długo. Kopia fizyczna to kopia plików bazy, szybsza przy dużych wolumenach, lecz związana z konkretną wersją serwera. W większych projektach łączymy oba rodzaje.
Czym jest replikacja i kiedy jej potrzebuję?
Replikacja to automatyczne kopiowanie zmian z głównej bazy na jedną lub więcej baz zapasowych. Przydaje się, gdy trzeba rozłożyć odczyty na kilka serwerów, szybko przełączyć się na zapasową bazę w razie awarii albo uruchamiać raporty bez obciążania produkcji. Nie zastępuje kopii zapasowych, bo przypadkowe usunięcie danych również zostanie zreplikowane.
Jak przygotować bazę na duży ruch w czasie promocji?
Kilka tygodni wcześniej analizujemy najwolniejsze i najczęstsze zapytania, sprawdzamy indeksy w tabelach zamówień i produktów, włączamy pamięć podręczną obiektów i przesuwamy ciężkie zadania, takie jak importy czy raporty, poza godziny promocji. Jeśli serwer na to pozwala, zwiększamy zasoby na czas akcji. Ważne jest też, by w trakcie promocji nie wdrażać zmian w strukturze bazy.
Czy hosting współdzielony wystarczy dla bazy sklepu?
Na początku działalności często tak. Z czasem ograniczenia zaczynają przeszkadzać: brak wpływu na konfigurację serwera bazy, limity jednoczesnych połączeń i zasoby dzielone z innymi klientami. Gdy panel zwalnia mimo poprawionych zapytań, a ruch i liczba produktów rosną, rekomendujemy serwer z dedykowanymi zasobami albo zarządzaną bazę w chmurze.
Czy można bezpiecznie dać zespołowi dostęp do bazy w celach analitycznych?
Tak, ale nie do bazy produkcyjnej z pełnymi uprawnieniami. Najlepiej przygotować replikę lub osobną bazę raportową, a w niej widoki zawierające tylko potrzebne kolumny, bez danych osobowych. Konto analityka ma wtedy prawo wyłącznie do odczytu, a błędnie napisane zapytanie nie spowolni sklepu.
Co zrobić, gdy po przeniesieniu strony zamiast polskich liter są krzaki?
Przede wszystkim nie zapisywać nowych treści, dopóki problem nie zostanie rozwiązany, bo każdy zapis może utrwalić błędne znaki. Przyczyną jest zwykle niezgodność kodowania między plikiem eksportu, bazą docelową i połączeniem aplikacji. Najbezpieczniej powtórzyć eksport i import z jawnie określonym kodowaniem, a dopiero gdy to niemożliwe, naprawiać dane konwersją na kopii.
Czy warto uczyć się SQL, pracując w marketingu?
Coraz częściej tak. Podstawy SQL, czyli wybieranie kolumn, filtrowanie, grupowanie i łączenie tabel, wystarczą, by samodzielnie analizować dane z GA4 w BigQuery czy eksport z Search Console i nie czekać na każdy raport od analityka. Zaawansowane zapytania i projekt struktur danych warto zostawić specjalistom, ale znajomość podstaw ułatwia współpracę i zadawanie właściwych pytań.
Jak sprawdzić, czy kopia zapasowa bazy naprawdę działa?
Jedynym pewnym sposobem jest jej odtworzenie. Przywracamy kopię na osobnym serwerze lub środowisku testowym, uruchamiamy na niej stronę i sprawdzamy, czy dane są kompletne i aktualne. Przy okazji mierzymy, ile czasu zajmuje odtworzenie, bo to informacja kluczowa w razie awarii. Sam fakt, że plik kopii istnieje i ma spodziewany rozmiar, niczego nie gwarantuje.
Co obejmuje audyt bazy danych?
Przegląd wersji i konfiguracji serwera, struktury tabel, indeksów i kodowania znaków, analizę wolnych i najczęściej wykonywanych zapytań, kontrolę uprawnień kont i dostępności bazy z zewnątrz oraz sprawdzenie, czy kopie zapasowe da się odtworzyć. Wynikiem jest lista problemów uporządkowana według wpływu i pracochłonności. Audyt można połączyć z szerszym przeglądem strony w ramach naszych audytów.
Czy połączycie dane ze sklepu z danymi z Google Analytics?
Tak. Najczęściej łączymy surowe dane GA4 wyeksportowane do BigQuery z danymi zamówień po identyfikatorze transakcji. Pozwala to uwzględnić zwroty, anulowane zamówienia i marżę, których narzędzie analityczne samo nie zna. Wyniki prezentujemy w raportach odświeżanych automatycznie, dostępnych dla zespołu marketingu i zarządu.
Lista kontrolna

Osiem rzeczy, które warto sprawdzić w bazie swojej strony lub sklepu

Ta lista nie zastąpi audytu, ale pozwala szybko ocenić, czy baza jest w dobrej kondycji. Jeśli przy którymś punkcie nie znasz odpowiedzi, zapytaj osobę odpowiedzialną za serwer.

  • Kopie zapasowe są testowane. Wiadomo, gdzie się znajdują, jak często powstają i kiedy ostatnio sprawdzono, że da się z nich odtworzyć bazę.
  • Wersja serwera bazy jest wspierana. Otrzymuje poprawki bezpieczeństwa, a termin zakończenia jej wsparcia jest znany.
  • Kodowanie znaków jest spójne. Baza, tabele i połączenie aplikacji korzystają z tego samego kodowania, w MySQL i MariaDB z utf8mb4.
  • Baza nie jest dostępna z internetu. Port serwera bazy jest zamknięty dla połączeń z zewnątrz, a narzędzia administracyjne w przeglądarce są zabezpieczone.
  • Aplikacja ma własne konto z ograniczonymi uprawnieniami. Nie łączy się z bazą jako administrator serwera.
  • Wolne zapytania są rejestrowane. Dziennik wolnych zapytań lub statystyki zapytań są włączone, a ktoś okresowo je przegląda.
  • Rozmiar największych tabel jest kontrolowany. Wiadomo, które tabele rosną najszybciej i czy wynika to z rzeczywistej działalności, czy z nagromadzonych zbędnych danych.
  • Kopie testowe nie zawierają prawdziwych danych klientów. Bazy na środowiskach deweloperskich są zanonimizowane.
Słowniczek

Pojęcia bazodanowe, które warto znać

Kompendium wyjaśnia kategorie poleceń SQL. Tu zebraliśmy pojęcia, które pojawiają się w rozmowach o wydajności, bezpieczeństwie i projektowaniu baz.

Klucz główny
Kolumna lub zestaw kolumn jednoznacznie identyfikujący każdy wiersz tabeli, na przykład numer zamówienia. Nie może się powtarzać ani być pusty.
Klucz obcy
Kolumna wskazująca na klucz główny innej tabeli. Pozwala bazie pilnować, by powiązania między danymi były zawsze poprawne.
Indeks
Dodatkowa struktura danych przyspieszająca wyszukiwanie wierszy. Przyspiesza odczyt, ale spowalnia zapisy i zajmuje miejsce.
Transakcja i ACID
Grupa operacji wykonywanych jako całość: albo wszystkie się udają, albo żadna. Skrót ACID opisuje jej cechy: niepodzielność, spójność, izolację i trwałość.
Zakleszczenie
Sytuacja, w której dwie transakcje czekają na siebie nawzajem, bo każda zablokowała dane potrzebne drugiej. Baza przerywa wtedy jedną z nich.
JOIN
Operacja łączenia wierszy z dwóch lub więcej tabel na podstawie powiązanych kolumn, na przykład zamówień z danymi klientów.
Widok
Zapisane zapytanie, z którego można korzystać jak z tabeli. Ułatwia raportowanie i pozwala udostępnić tylko wybrane kolumny.
Wyzwalacz
Kod uruchamiany automatycznie przez bazę przy dodaniu, zmianie lub usunięciu wiersza. Przydatny, ale nadużywany utrudnia zrozumienie logiki aplikacji.
Procedura składowana
Program zapisany w bazie danych i wykonywany po stronie serwera bazy. Spotykana głównie w systemach firmowych i integracjach.
Collation
Zestaw reguł porównywania i sortowania tekstu, na przykład czy wielkość liter ma znaczenie i jak sortować polskie znaki.
ORM
Warstwa w aplikacji, która tłumaczy operacje na obiektach na zapytania SQL. Ułatwia pracę, ale wymaga kontroli generowanych zapytań.
Replika
Kopia bazy aktualizowana na bieżąco zmianami z bazy głównej. Służy do rozłożenia odczytów, raportów i szybkiego przełączenia w razie awarii.
Plan wykonania
Opis tego, jak baza zamierza wykonać zapytanie: z których indeksów skorzysta i w jakiej kolejności połączy tabele. Wyświetla się go poleceniem EXPLAIN.
Upsert
Operacja, która wstawia nowy wiersz albo aktualizuje istniejący, jeśli rekord o danym kluczu już jest w tabeli. Podstawa bezpiecznych importów danych.
Porozmawiajmy o Twojej bazie

Strona zwalnia, planujesz migrację albo potrzebujesz raportów z danych?

Opisz nam problem lub cel. Sprawdzimy bazę, wskażemy przyczyny spowolnień i zaproponujemy plan działań: od szybkich poprawek po przebudowę struktury danych czy wdrożenie raportowania.

4.8/5 - 932

Zostaw komentarz

Twój adres e-mail nie zostanie opublikowany. Komentarze są moderowane.

Porozmawiajmy o Twoim projekcie

Bezpłatnie sprawdzimy Twoją stronę i zaproponujemy plan działań. Odpowiadamy tego samego dnia, dyżur eksperta 24/7.